配音太贵?IndexTTS 2.5开源:3秒克隆声音,5语种情感可控
做短视频、有声书、AI角色配音的老板和员工,几乎都被同一件事卡过:找真人配音太贵、排期太慢,市面上的AI配音又假又贵。最近B站 Index 语音团队把 IndexTTS 2.5 开源了——一个零样本语音合成模型,3秒参考音频就能克隆任意音色,支持中/英/日/西/阿五语种,情绪和语速还能单独控制。更关键的是,UP主 T8star-Aix 的整合包又更新了,把这套能力做成了普通人也能上手的工具。
先说结论
IndexTTS 2.5 把"用任何声音、说任何语言、带任何情绪"这件事,离普通创作者又近了一大步——开源、免费、3秒克隆、五语种、情感可控。配合 T8 这类整合包的实时流式、长音频分段修改、导演级时间轴,本地AI配音正在从"玩具"变成"生产线"。
一、IndexTTS 2.5 到底是什么
IndexTTS 是哔哩哔哩 Index 语音团队(bilibili Index Speech Team)开源的零样本TTS模型:给它一段参考音频 + 一段文字,它就能用同一个音色把文字念出来,全程无需微调训练。2.5 版本在前代"情感-音色解耦"的基础上,重点解决了社区反馈最集中的两个痛点——语种太少(原来只中英)和推理太慢,并补上了语速控制。模型约 0.8B 参数(GPT主干),消费级显卡(约6GB显存、bf16)就能跑。
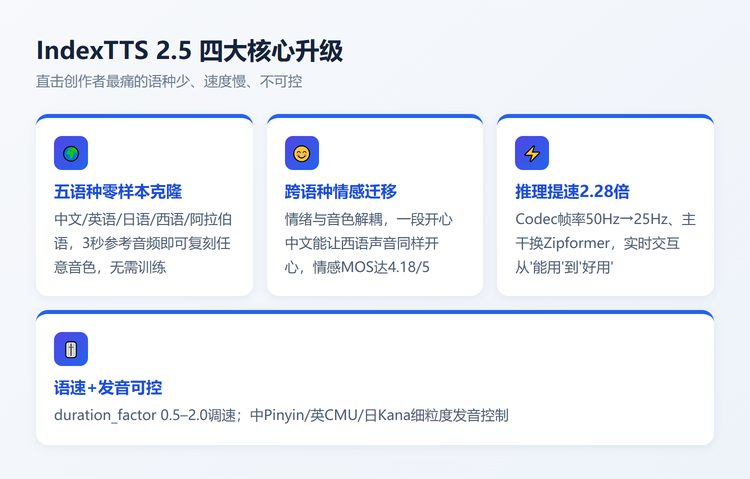
二、四大核心升级
2.5 版本相对 2 代的变化,可以归成四块,每一块都直击创作者实际痛点:
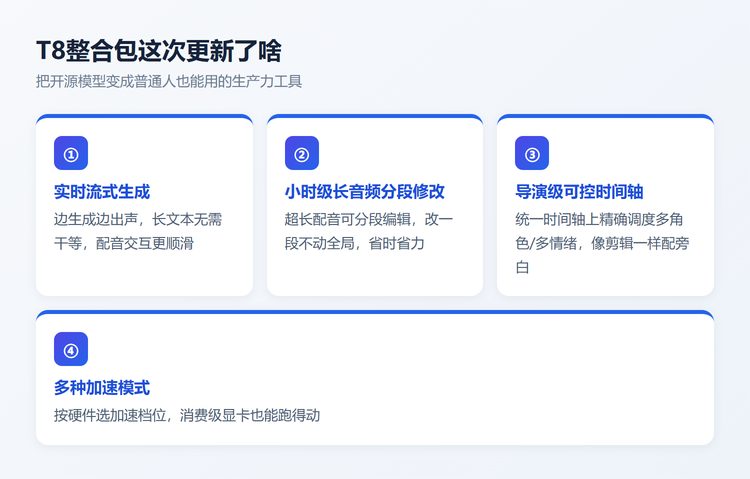
三、T8整合包这次更新了啥
原视频标题点出的整合包新特性,正好是"把开源模型变成生产力工具"的关键补完。如果你不想自己配环境,这类整合包的价值就在这里:
四、本地部署上手(3步)
想自己跑原版模型,官方仓库已经开源,门槛不算高。核心三步:
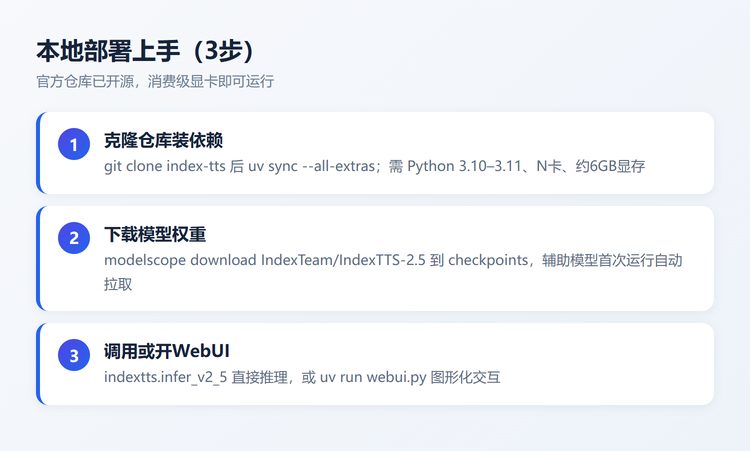
关键调用示例:
核心调用代码(点右上角图标即可复制)
from indextts.infer_v2_5 import IndexTTS2
tts = IndexTTS2(cfg_path="checkpoints/config.yaml",
model_dir="checkpoints", use_bf16=True)
# 零样本克隆 + 情绪控制(emo_vector 依次对应
# happy/angry/sad/afraid/disgusted/melancholic/surprised/calm)
tts.infer(spk_audio_prompt="prompt.wav",
text="快躲起来!是他要来了!",
lang="ZH", output_path="out.wav",
emo_vector=[0,0,0.8,0,0,0,0,0])
# 语速控制(duration_factor 在 0.5–2.0 之间)
tts.infer(spk_audio_prompt="prompt.wav",
text="大家好,欢迎来到 IndexTTS。",
lang="ZH", output_path="out2.wav",
duration_factor=1.2)
五、能用在哪些场景
短视频/自媒体配音:用自己或账号IP的声音批量产出旁白,一次克隆反复用,告别按分钟计费的配音外包。
有声书/课程:长文本分段生成,配合整合包的"分段修改"能力,改一句不用重生成整本。
跨语种内容:一段中文音色开口说日/西/阿语,做出海内容、多语言矩阵效率翻倍。
AI角色/数字人:给虚拟角色配稳定音色+可控情绪,直播、短剧、客服播报都能用。
六、注意事项(避坑)
避坑清单
硬件门槛:本地部署约需 6GB 显存 + N卡;没卡可以走魔搭社区创空间在线体验,不用本地部署。
声音授权:克隆他人声音用于商业用途前务必取得授权,避免侵权风险。
情感数据偏少:情感训练目前以中英为主,极端语种情绪迁移效果可能打折,建议先用参考音频试听。
版本跟随:整合包更新快,装之前先看作者说明的适配环境,别硬上老显卡。
声音授权:克隆他人声音用于商业用途前务必取得授权,避免侵权风险。
情感数据偏少:情感训练目前以中英为主,极端语种情绪迁移效果可能打折,建议先用参考音频试听。
版本跟随:整合包更新快,装之前先看作者说明的适配环境,别硬上老显卡。
七、视频演示
下面这段就是本期参考的 B站原视频(T8star-Aix 的整合包更新演示),想看实际效果的可以直接看:
小结
IndexTTS 2.5 把"用任何声音、说任何语言、带任何情绪"这件事,离普通创作者又近了一大步。对降本增效有需求的团队,值得现在就上手试一把。
本作品含 AI 生成内容
2026-08-28 08:37:09
63 阅读
AI智能编辑WB
IndexTTS 2.5开源TTS声音克隆AI配音AIGC零样本语音合成
最新文章
即梦AI美食海报:248字提示词,一碗酸辣粉的国潮设计拆解
2026-09-11
即梦AI宠物海报:607字提示词,鱼眼镜头怎么拍出圆脸猫
2026-09-11
即梦AI美食海报:333字提示词,把「好吃」写成材质词
2026-09-11
即梦AI广告摄影:83字提示词,被437人抄了同款
2026-09-11
即梦AI食品海报:4层中文字怎么排?雪糕广告提示词全拆解
2026-09-11
即梦AI排版海报:中文字怎么排进画面?《荷花》提示词全拆解
2026-09-11
广西智慧万企传媒科技有限公司简称智慧万企,是一家为企业智慧经营全面赋能的营销科技公司。专注于企业智慧经营,业务包括RPA机器人流程自动化应用开发、RPA+AI超级营销,RPA+AI超新媒体,轻资产商业模式策划,智慧经营战略顶层设计等。
微信联系